
📝 本系列為 iThome 鐵人賽學習筆記,屬個人教學與非商業用途;文中法規與標準內容均以自身理解後的話轉述並註明出處,非逐字引用。
階段四|怎麼落地:從技術棧示範
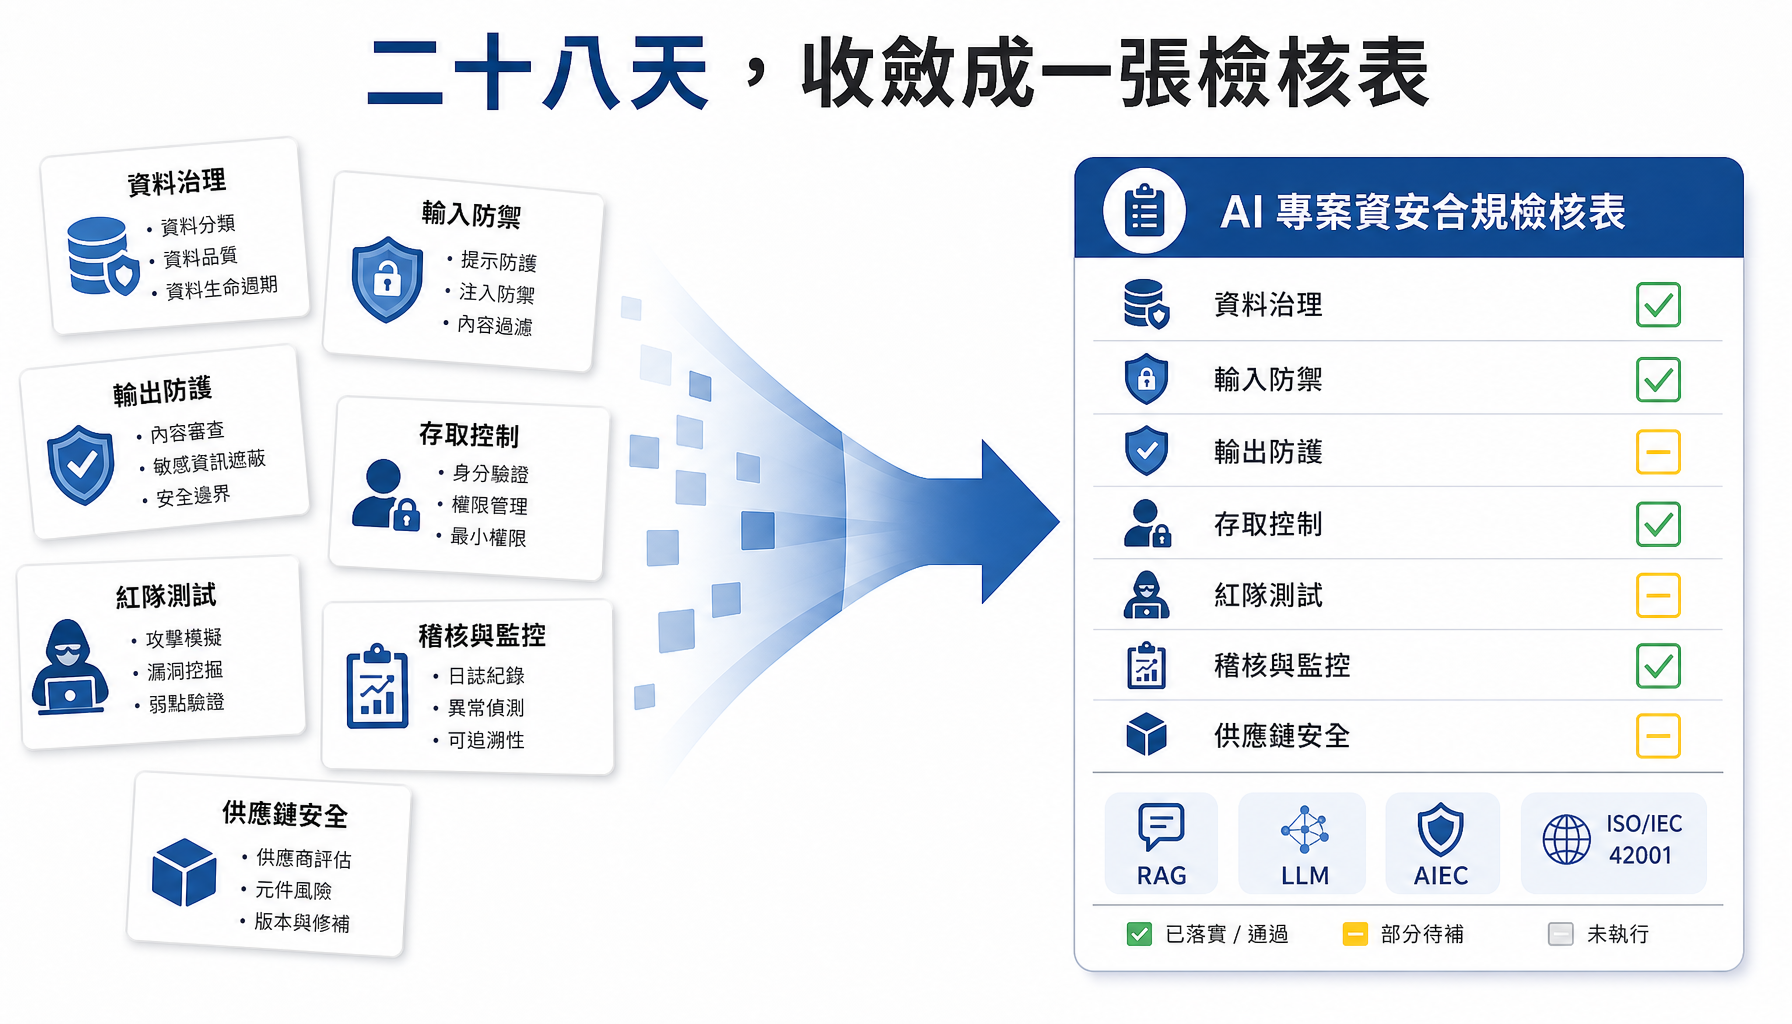
這個系列走到今天,已經累積了很多東西:前三個階段講清楚了「法規要求什麼、標準怎麼導入、台灣有哪些評測機構」,第四階段(Day 21–28)則把這些抽象要求,一天一天地變成了真正跑得起來的程式——資料治理、輸入防禦、輸出防護、存取控制、紅隊測試、稽核日誌、供應鏈治理。
但這裡有一個現實問題:這些散落在二十八天裡的知識與程式,別人(主管、稽核員、採購方、認證機構)要怎麼「一眼看懂到底做了沒、做全了沒」? 總不能請他們把二十八篇文章從頭讀一遍。
所以整個系列的核心交付物,不是任何一段程式,而是今天要產出的這份東西——《AI 專案資安合規檢核表》。它把二十八天的所有內容收斂成一張表:每一項該檢查什麼、對應到哪條法規原則、哪個標準控制、用什麼技術落地、又該拿什麼佐證。
不過今天的重點,不只是把這張表列出來。檢核表這種東西有一個致命弱點:勾選太容易了。 所以今天真正要做的,是把這張表變成一支會回頭查核佐證的工具——你說做到了,它就去確認證據在不在。這才是它能被拿去面對稽核與採購的原因。
在動手之前,先想清楚它的價值。一份好的檢核表,把「安全」這件模糊的事,變成如下圖所示的四種具體能力:
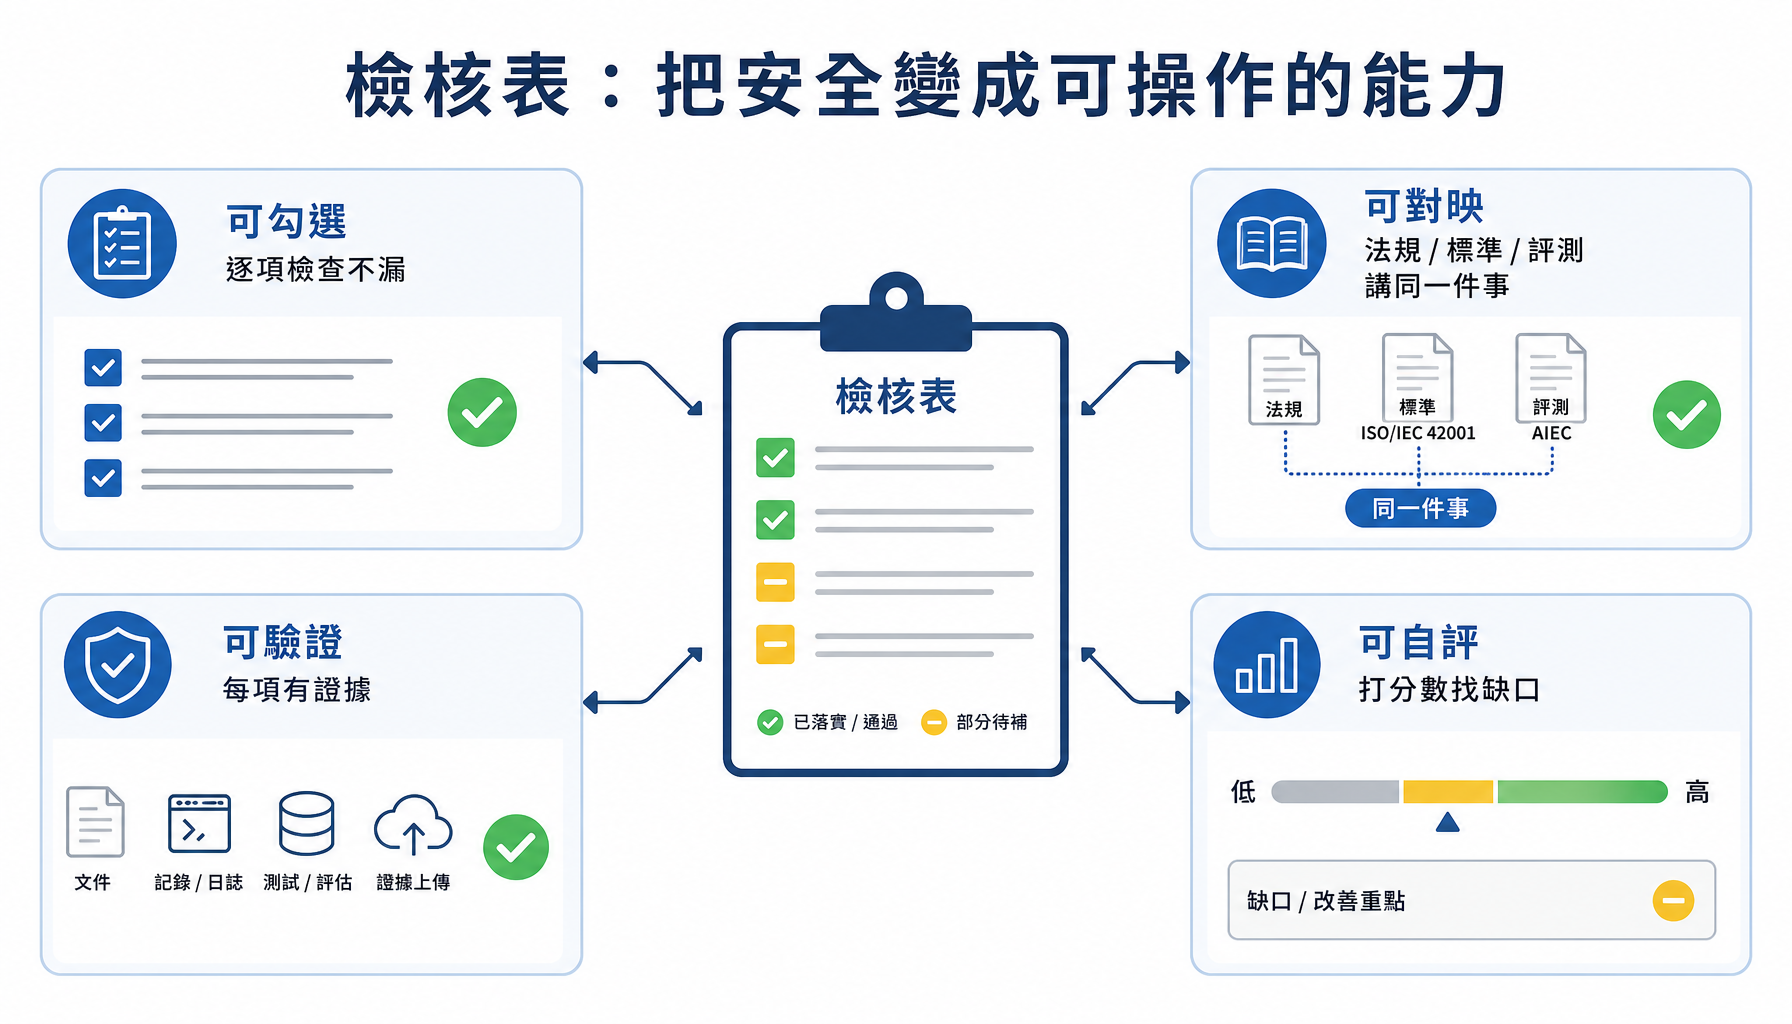
一句話:檢核表讓「安全」從一種感覺,變成一件可以被檢查、被證明、被交付的事——至少,理想上是這樣。
這張表要用什麼當骨架?答案在 Day 18 就埋好了伏筆——AI 產品與系統評測中心(Artificial Intelligence Evaluation Center,以下簡稱 AIEC)的十大評測項目。
用它當骨架有兩個好處。其一,它是台灣官方用來評測 AI 的十個面向(準確性、可靠性、彈性、安全性、資安、隱私、透明性、可解釋性、當責性、公平性),本土、權威、涵蓋完整。其二,這十項大致能對回《人工智慧基本法》第 4 條的七大原則(Day 8),往下又能接到 ISO/IEC 42001(人工智慧管理系統標準,Day 9–13)的控制——它天生就站在「法規、標準、評測」三者的交會點上,是最理想的收斂骨架。
於是每一項檢核,就長成一條完整的「從法條到程式碼」的鏈,如下圖所示:
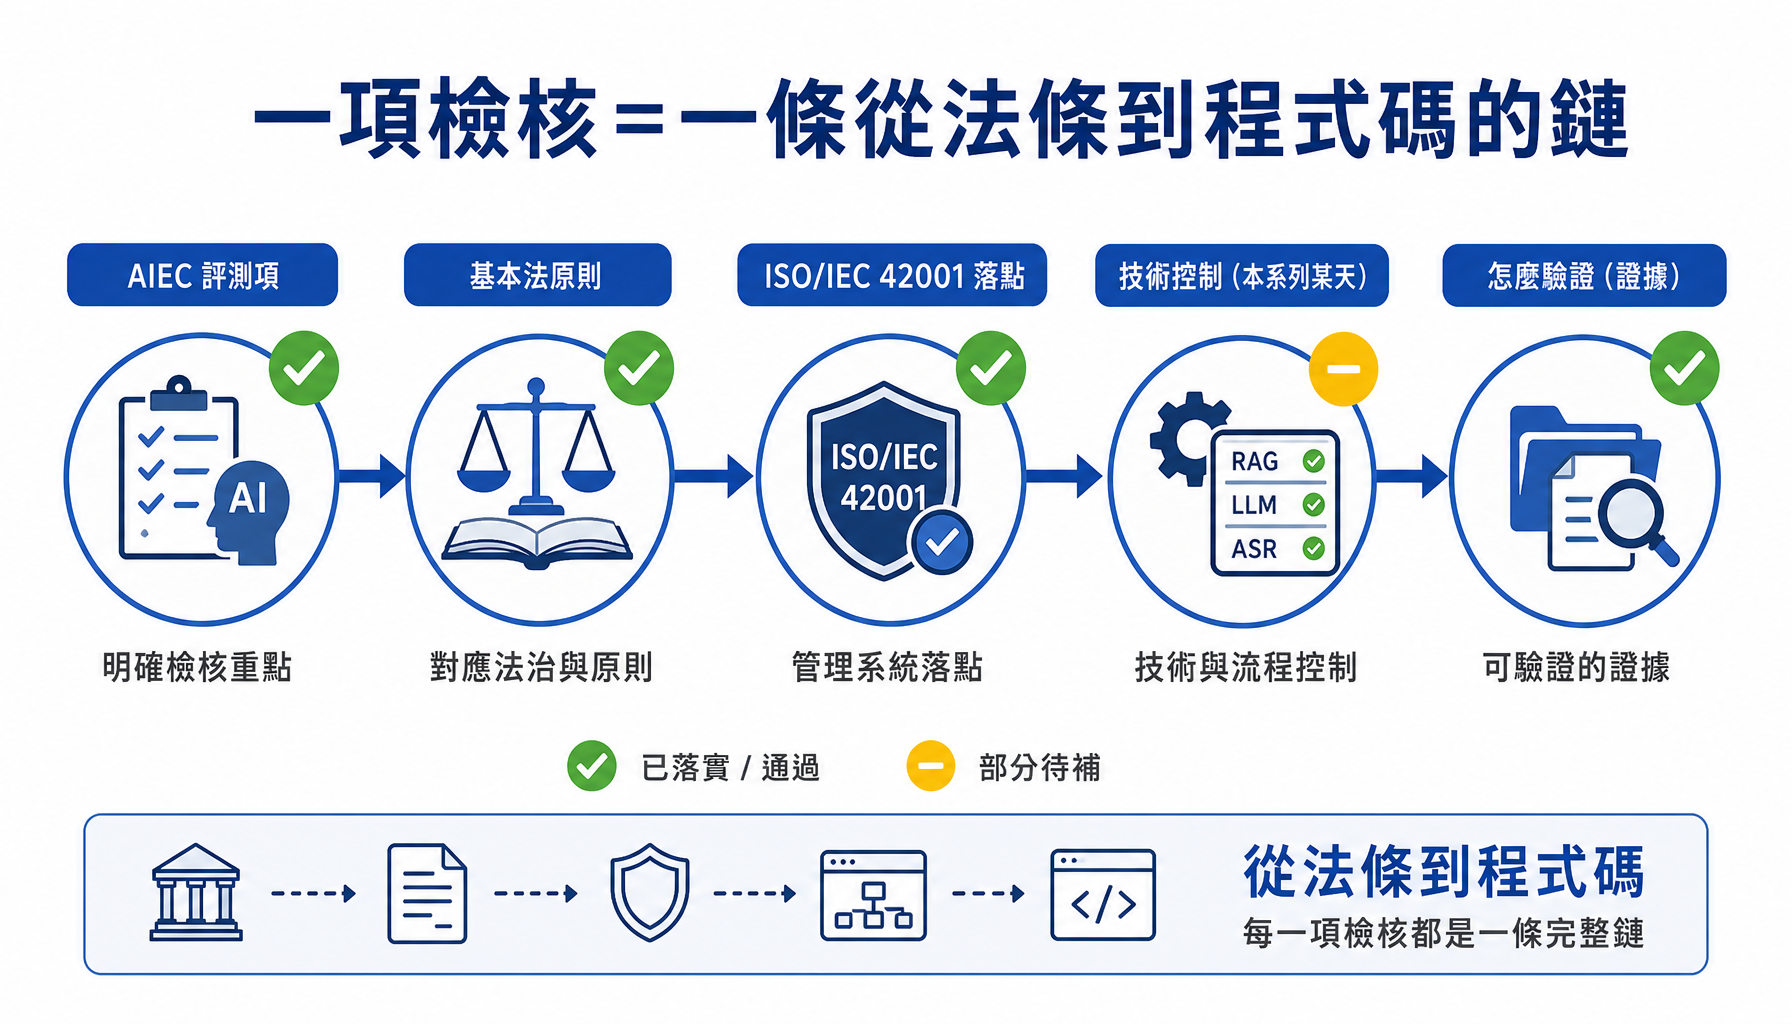
AIEC 評測項 → 對應基本法原則 → ISO/IEC 42001 落點 → 技術控制(本系列哪一天) → 佐證(拿什麼證明)
做這張表的過程中會撞到一個問題:十項評測與七大原則,並不是一對一的關係。 具體來說,「準確性」與「可靠性」這兩項,在七大原則裡找不到一條明確對應的。
這不是誰做錯了,而是兩套框架的出發點本來就不同。基本法第 4 條的七大原則是價值層的宣示——它關心的是 AI 會不會侵害隱私、會不會歧視、出事有沒有人負責,這些是「該不該做」的問題。AIEC 的十項則是評測層的量表——它要能對一個系統打分數,所以必然包含「答得準不準、穩不穩」這類純粹的品質指標。一個系統答錯率高,它不道德嗎?不算,但它就是不好用。
所以本檢核表誠實地把這兩項標為「品質面」,不硬湊一條原則上去。硬湊會讓對映表變好看,卻讓它變得不可信——當有人拿著這張表問「準確性到底對應第 4 條哪一款」,你會答不出來。
至於「彈性」,本表把它歸入「資安與安全」原則。這裡要說清楚:AIEC 對這一項的官方意涵,強調的是系統能隨情境、需求與外部條件變動而調整、擴充(見 Day 18)。本表取的是它的另一面——「受到擾動時撐得住、事後恢復得了」——認為這與資安原則要求的穩健性相通,才歸入該原則。這是本系列的判斷,不是官方對映。
以下就是這份《AI 專案資安合規檢核表》。每一列都是一條完整的五段鏈:
| ID | AIEC 評測項 | 基本法原則 | ISO/IEC 42001 落點 | 技術控制 | 佐證 |
|---|---|---|---|---|---|
| C1 | 資安 | 資安與安全 | 6.1.3 風險處理(引入 ISO/IEC 27001 控制)、A.10.3 供應者 | 輸入注入防禦(D23)、存取控制與工具權限把關(D25)、供應鏈完整性(D28) | 紅隊攻擊成功率歸零、越權工具呼叫全數被攔下(拒絕或改綁回本人)、AI-BOM 完整性驗證通過 |
| C2 | 安全性 | 資安與安全 | 附錄 A 衝擊評鑑與使用者資訊相關控制 | 輸出內容約束與免責提示(D24)、輸入層有害請求阻擋(D23) | 回覆附「不能取代專業醫療判斷」免責、涉病情提醒諮詢專業 |
| C3 | 彈性 | 資安與安全 | 附錄 A 驗證與測試相關控制 | 可重複執行的紅隊測試流程(D26) | 同一組攻擊案例庫可重跑,攻擊成功率有前後對照 |
| C4 | 隱私 | 隱私保護與資料治理 | 附錄 A 資料相關控制 | 去識別化與資料最小化(D22)、出口遮蔽(D24)、存取控制(D25) | 治理後知識庫查無個資、跨租戶存取被擋 |
| C5 | 準確性 | (品質面) | 附錄 A 品質相關控制 | grounding 幻覺防護(D24) | 檢索依據不足時不硬答,改以「查無資料」回覆 |
| C6 | 可靠性 | (品質面) | 附錄 A 驗證與供應者相關控制 | 紅隊測試(D26)、供應鏈版本釘選(D28) | 攻擊成功率指標、元件指紋比對通過 |
| C7 | 透明性 | 透明與可解釋 | 附錄 A 資訊揭露相關控制 | 來源標註與 AI 生成聲明(D24) | 每則回覆附上依據來源與 AI 生成聲明 |
| C8 | 可解釋性 | 透明與可解釋 | 附錄 A 資訊揭露相關控制 | 檢索來源可追溯設計(D24) | 答案可回溯至 RAG 實際引用的知識庫段落 |
| C9 | 當責性 | 問責 | 附錄 A 紀錄與事件管理相關控制 | 雜湊鏈稽核日誌(D27) | 日誌遭竄改時可偵測斷鏈 |
| C10 | 公平性 | 公平與不歧視 | 附錄 A 資料與影響評估相關控制 | 資料源頭治理(D22)、偏誤探測 | 分群偏誤量測報告 |
(表中 D22 即 Day 22,以此類推。檢索增強生成(Retrieval-Augmented Generation,以下簡稱 RAG)見 Day 21;攻擊成功率見 Day 5 與 Day 26;AI 物料清單(AI Bill of Materials,簡稱 AI-BOM)見 Day 28。)
讀過 Day 20 的讀者會發現,那一天已經用類似的形狀,把這十項翻譯成過標案語言。今天這張表多了兩樣東西:往上補齊了「基本法原則」這一欄,往下把「佐證」從一句描述,換成一份指得出檔案路徑的清單——後者正是接下來那支程式能查得動它的原因。
這張表最值得玩味的是最後兩欄:技術控制欄,把每一項抽象的評測,接回本系列某一天寫過的真實程式;佐證欄,則把每一項的「怎麼證明」寫成具體、可執行的檢查。這就是「從法條到程式碼」最完整的一次呈現——一份法務看得懂、工程師做得出、稽核員驗得了的共同語言。
但表格列到這裡,一個尷尬的事實浮上來:上面每一格的「佐證」欄,目前都只是一句話。
沒有任何機制阻止一個人把十項全部勾成「已落實」。填表的人不必真的做過紅隊測試,也能寫下「攻擊成功率歸零」;不必真的建過稽核日誌,也能寫下「可偵測斷鏈」。一張全綠的檢核表,跟一張誠實的檢核表,在紙上長得一模一樣。
這正是採購方與稽核員對自評表最深的不信任來源,也是 Day 20 那條心法「證據勝於形容詞」要處理的問題。
所以今天要做的,是把佐證欄從「一句話」升級成「一份必須真的存在的東西」:
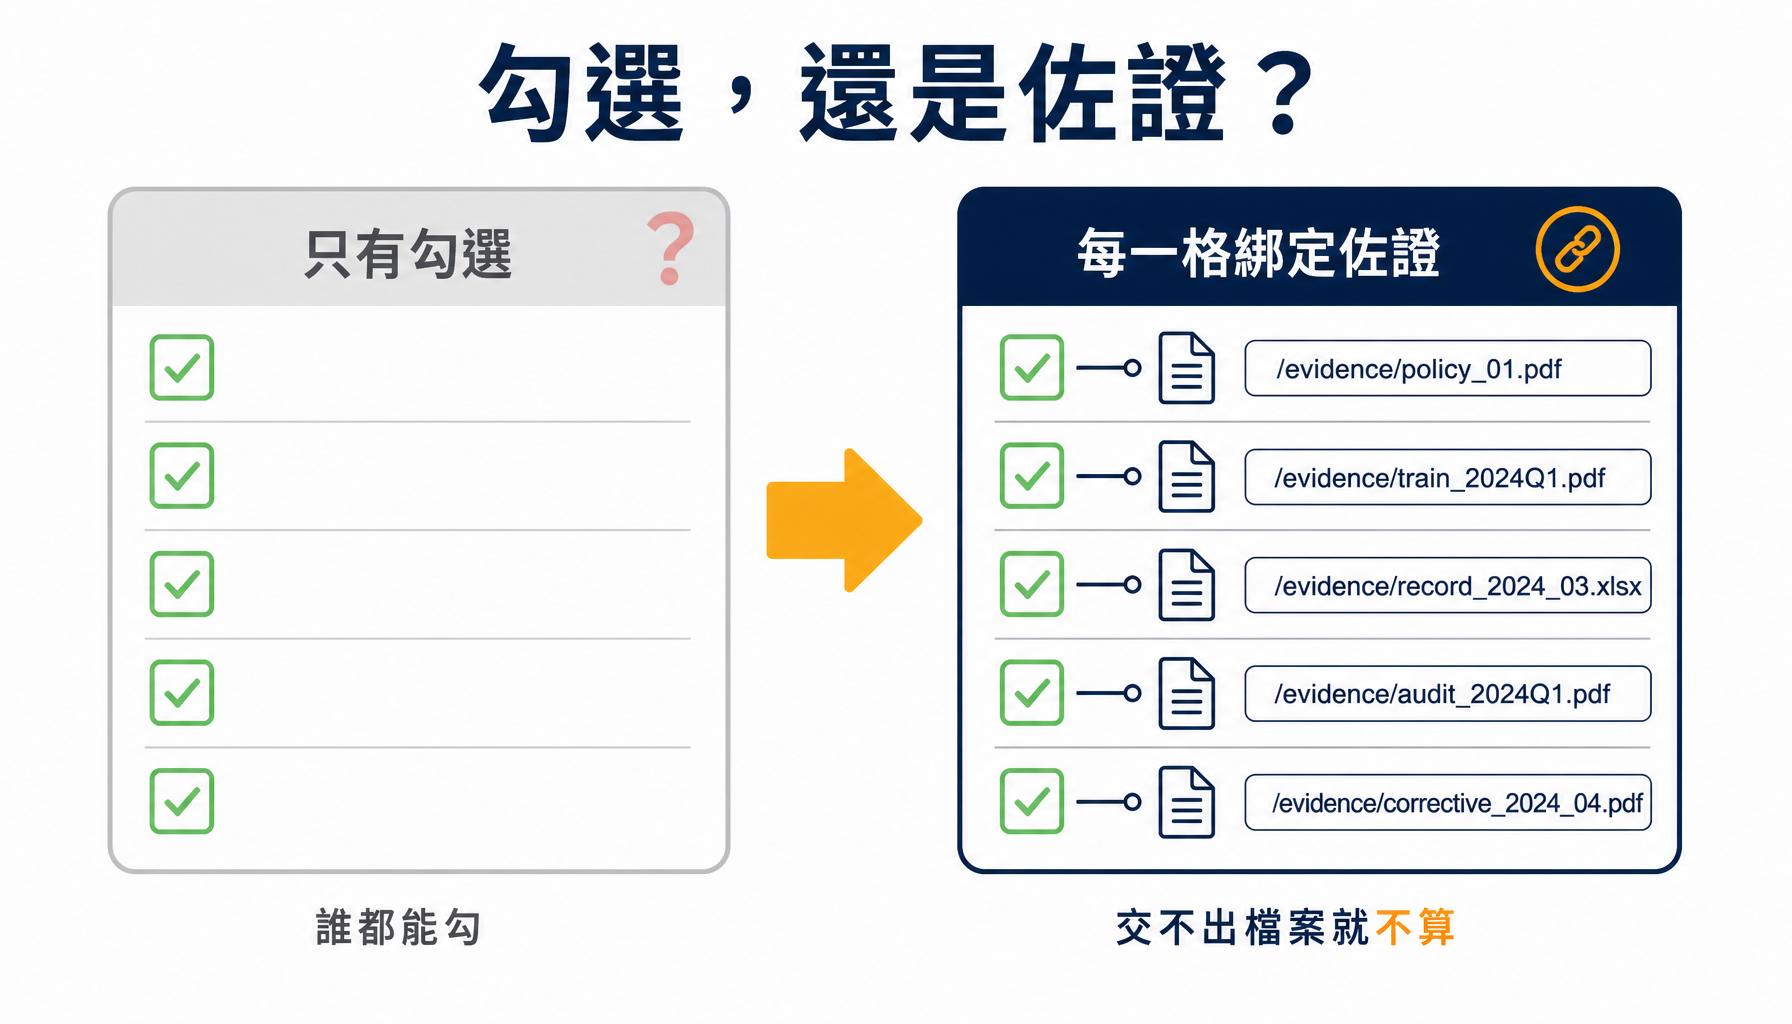
規則只有一條,但它改變了這張表的性質:
宣稱「已落實」,但佐證檔案不存在者,一律不予採認。
完整檔在 程式碼/Day29/compliance_checklist.py。以下依序拆解。
先是匯入與兩份對照字典——_MARK 供終端報告使用,_TENDER 則把內部狀態翻成標案文件慣用的措辭;以及讀取自評檔的函式:
import json
import os
import sys

# 專案根目錄(本檔在 程式碼/Day29/,往上三層即根)
ROOT = os.path.dirname(os.path.dirname(os.path.dirname(os.path.abspath(__file__))))
HERE = os.path.dirname(os.path.abspath(__file__))

_MARK = {"done": "🟢 已落實", "partial": "🟡 部分", "todo": "🔴 未落實"}
_TENDER = {"done": "符合", "partial": "部分符合", "todo": "不符合"}


def load_assessment(path):
    """讀取自評檔(id → done/partial/todo)。找不到就回傳全部 todo。"""
    if not os.path.exists(path):
        print(f"⚠️  找不到自評檔 {path},視為全部尚未落實。")
        return {}
    with open(path, encoding="utf-8") as f:
        return json.load(f)["status"]
ROOT 指向專案根目錄,因為佐證路徑(如 程式碼/Day23/input_defense_rag.py)都是以根目錄為基準寫的。load_assessment() 找不到檔案時不會直接崩潰,而是回傳空字典——後續每一項都會被當成「尚未落實」,這是比較安全的預設。
先把上面那張表寫成程式讀得懂的資料。與前面幾天不同的是,每一項多了一個 evidence 欄——它不是描述,而是檔案路徑清單:
# 每一項的 evidence 欄,是「宣稱做到就必須交得出來」的檔案清單。
# 工具會逐一確認這些路徑存在——這是「有勾」與「做對」之間唯一的機械化把關。
CHECKLIST = [
    {"id": "C1", "aiec": "資安", "principle": "資安與安全",
     "iso": "6.1.3 風險處理(引入 ISO/IEC 27001 控制)、A.10.3 供應者",
     "controls": "輸入注入防禦(D23)、存取控制與工具權限把關(D25)、供應鏈完整性(D28)",
     "verify": "紅隊攻擊成功率歸零、越權工具呼叫全數被攔下(拒絕或改綁回本人)、AI-BOM 完整性驗證通過",
     "evidence": ["程式碼/Day23/input_defense_rag.py",
                  "程式碼/Day25/access_control_rag.py",
                  "程式碼/Day25/tool_calling_guard.py",
                  "程式碼/Day28/ai_bom.py"]},

    # …… C2 至 C9 同一結構,逐項對應到前面各天寫過的程式 ……

    {"id": "C10", "aiec": "公平性", "principle": "公平與不歧視",
     "iso": "附錄 A 資料與影響評估相關控制",
     "controls": "資料源頭治理(D22)、偏誤探測",
     "verify": "分群偏誤量測報告",
     "evidence": ["程式碼/Day22/data_governance_demo.py",
                  "程式碼/Day26/bias_probe.py"]},   # ← 這支還不存在,見實跑結果
]
十項的結構完全一致,中間八項的欄位內容即上方那張表的 C2 至 C9 列,此處不再重複。請特別留意 C10 的第二份佐證 bias_probe.py 並不存在——本系列沒有做過正式的偏誤量測。這不是疏漏,而是刻意留著的:等一下要用它來示範,這支工具會不會放行一個交不出證據的宣稱。
第二個關鍵改變:專案的落實狀態不寫在程式裡,而是獨立成一份 assessment.json。
{
  "project": "本系列 RAG 醫院客服 demo",
  "date": "2026-09",
  "note": "誠實版:C10 公平性只做了資料源頭治理,尚未做正式的分群偏誤量測,故填 partial。",
  "status": {
    "C1": "done", "C2": "done", "C3": "done", "C4": "done", "C5": "done",
    "C6": "done", "C7": "done", "C8": "done", "C9": "done",
    "C10": "partial"
  }
}
這樣切開有一個很實際的理由:檢核表是共用的骨架,自評狀態是每個專案自己的。 換一個專案來用這套工具,只要換掉這份 JSON,程式一行都不必動。這也是 Day 20 所說「用同一套底稿應對多個標案」的具體實作。
接著是整支工具的核心。它只做一件事——把「宣稱」拿去對照「檔案在不在」:
def check_evidence(item):
    """回傳這一項所宣稱的佐證中,實際不存在的檔案清單。"""
    return [p for p in item["evidence"] if not os.path.exists(os.path.join(ROOT, p))]


def audit(assessment):
    """
    逐項查核:把「宣稱狀態」對照「佐證是否存在」,產出查核後的結果。

    規則只有一條,但這是整支工具的核心——
    宣稱 done、卻有任何一份佐證檔案不存在者,一律降級為 unproven(佐證缺漏)。
    """
    rows = []
    for c in CHECKLIST:
        claimed = assessment.get(c["id"], "todo")
        missing = check_evidence(c)
        verdict = "unproven" if (claimed == "done" and missing) else claimed
        rows.append({"item": c, "claimed": claimed, "verdict": verdict, "missing": missing})
    return rows
audit() 刻意把「宣稱」(claimed)與「查核結果」(verdict)分開存放。這個區分很重要:報告要能同時說出「你說你做到了」與「但證據不足」,而不是把兩者混成一個結論。
這道查核當然很粗淺——它只確認檔案存在,不會讀內容、不會判斷做得對不對(這一點在文末「查核了檔案,不等於查核了品質」一節會再談)。但它擋掉了最常見、也最廉價的那種造假:憑空勾選。
有了查核結果,接著把它印成人看得懂的報告:
def render_report(rows, source):
    """印出查核報告:逐項狀態、佐證缺漏、以及待補清單。"""
    print("=" * 78)
    print(f"合規自評查核報告  資料來源:{source}")
    print("=" * 78)
    for r in rows:
        c, verdict = r["item"], r["verdict"]
        mark = "❌ 佐證缺漏" if verdict == "unproven" else _MARK[verdict]
        print(f"  [{c['id']:>3}] {c['aiec']:<5}{mark}")
        if verdict == "unproven":
            print("        宣稱已落實,但下列佐證不存在:")
            for m in r["missing"]:
                print(f"          - {m}")
        elif verdict != "done":
            print(f"        待補:{c['verify']}")

    proven = [r for r in rows if r["verdict"] == "done"]
    unproven = [r for r in rows if r["verdict"] == "unproven"]
    gaps = [r for r in rows if r["verdict"] in ("partial", "todo")]

    print("-" * 78)
    print(f"佐證齊備:{len(proven)}/{len(CHECKLIST)} 項 "
          f"佐證缺漏:{len(unproven)} 項 尚待補齊:{len(gaps)} 項")
    if unproven:
        print("\n⚠️  下列項目宣稱已落實,但交不出佐證——送審前必須先補齊檔案或改回實際狀態:")
        for r in unproven:
            print(f"    - [{r['item']['id']}] {r['item']['aiec']}")
    if gaps:
        print("\n下一步要補的功課:")
        for r in gaps:
            print(f"    - [{r['item']['id']}] {r['item']['aiec']}:{r['item']['verify']}")
這裡刻意把結果分成三堆印出來:proven(佐證齊備)、unproven(宣稱了但交不出證據)、gaps(誠實承認還沒做完)。第二堆與第三堆的性質完全不同——前者是填表的人有問題,後者是專案還沒做完——混在一起就看不出差別了。
最後一步,把查核結果輸出成 Day 20 介紹的標案自評表格式(要求項目/符合狀態/實作做法/佐證文件):
def render_tender_table(rows):
    """輸出可直接貼進標案文件的 Markdown 自評表(Day 20 的四欄格式)。"""
    lines = ["# AI 系統資安自評表", "",
             "> 依《AI 專案資安合規檢核表》產出;欄位格式沿用 Day 20 所述之標案自評表。", "",
             "| 要求項目 | 符合狀態 | 實作做法 | 佐證文件 |",
             "| --- | --- | --- | --- |"]
    for r in rows:
        c = r["item"]
        state = "佐證缺漏" if r["verdict"] == "unproven" else _TENDER[r["verdict"]]
        # 佐證欄只列「真的存在」的檔案;缺的另外註明,不讓交出去的表格灌水。
        have = [p for p in c["evidence"] if p not in r["missing"]]
        proof = "、".join(have) if have else "(尚無)"
        if r["missing"]:
            proof += f"(尚缺:{'、'.join(r['missing'])})"
        lines.append(f"| {c['aiec']}:{c['verify']} | {state} | {c['controls']} | {proof} |")
    return "\n".join(lines) + "\n"
注意那行註解所處理的細節:佐證欄只列真的存在的檔案,缺的另外註明。 一份要交給採購方的文件,如果把不存在的檔名也列進去,那就從「自評」變成「不實陳述」了——Day 20 談過這件事的法律後果。
主程式把三件事串起來:讀自評檔、查核、輸出。
if __name__ == "__main__":
    src = sys.argv[1] if len(sys.argv) > 1 else "assessment.json"
    rows = audit(load_assessment(os.path.join(HERE, src)))
    render_report(rows, src)

    out = os.path.join(HERE, "自評表.md")
    with open(out, "w", encoding="utf-8") as f:
        f.write(render_tender_table(rows))
    print(f"\n📄 已輸出可交付的自評表 → {os.path.basename(out)}")
至此,整支程式已依序呈現完畢——把上面各段依序合併,就是可直接執行的完整檔案。
先用誠實填寫的 assessment.json 跑一次(python compliance_checklist.py):
==============================================================================
合規自評查核報告  資料來源:assessment.json
==============================================================================
  [ C1] 資安   🟢 已落實
  [ C2] 安全性  🟢 已落實
  [ C3] 彈性   🟢 已落實
  [ C4] 隱私   🟢 已落實
  [ C5] 準確性  🟢 已落實
  [ C6] 可靠性  🟢 已落實
  [ C7] 透明性  🟢 已落實
  [ C8] 可解釋性 🟢 已落實
  [ C9] 當責性  🟢 已落實
  [C10] 公平性  🟡 部分
        待補:分群偏誤量測報告
------------------------------------------------------------------------------
佐證齊備:9/10 項 佐證缺漏:0 項 尚待補齊:1 項

下一步要補的功課:
    - [C10] 公平性:分群偏誤量測報告

📄 已輸出可交付的自評表 → 自評表.md
九項佐證齊備、一項誠實標記為「部分」。這裡刻意不給一個總分百分比:合規準備度這種單一數字看起來漂亮,但它由誰來定權重(隱私跟公平性等重嗎?)其實沒有依據,很容易變成自我安慰。真正有用的是最後那份待補清單——它告訴你下一步要做什麼。
現在做一件填表的人很容易做的事:反正資料治理有做,公平性就順手勾成「已落實」吧。把這個念頭寫成 assessment_optimistic.json,再跑一次(以下節錄,中間八項均為已落實):
==============================================================================
合規自評查核報告  資料來源:assessment_optimistic.json
==============================================================================
  [ C1] 資安   🟢 已落實
  ……(C2 至 C9 同前,均為已落實)……
  [C10] 公平性  ❌ 佐證缺漏
        宣稱已落實,但下列佐證不存在:
          - 程式碼/Day26/bias_probe.py
------------------------------------------------------------------------------
佐證齊備:9/10 項 佐證缺漏:1 項 尚待補齊:0 項

⚠️  下列項目宣稱已落實,但交不出佐證——送審前必須先補齊檔案或改回實際狀態:
    - [C10] 公平性
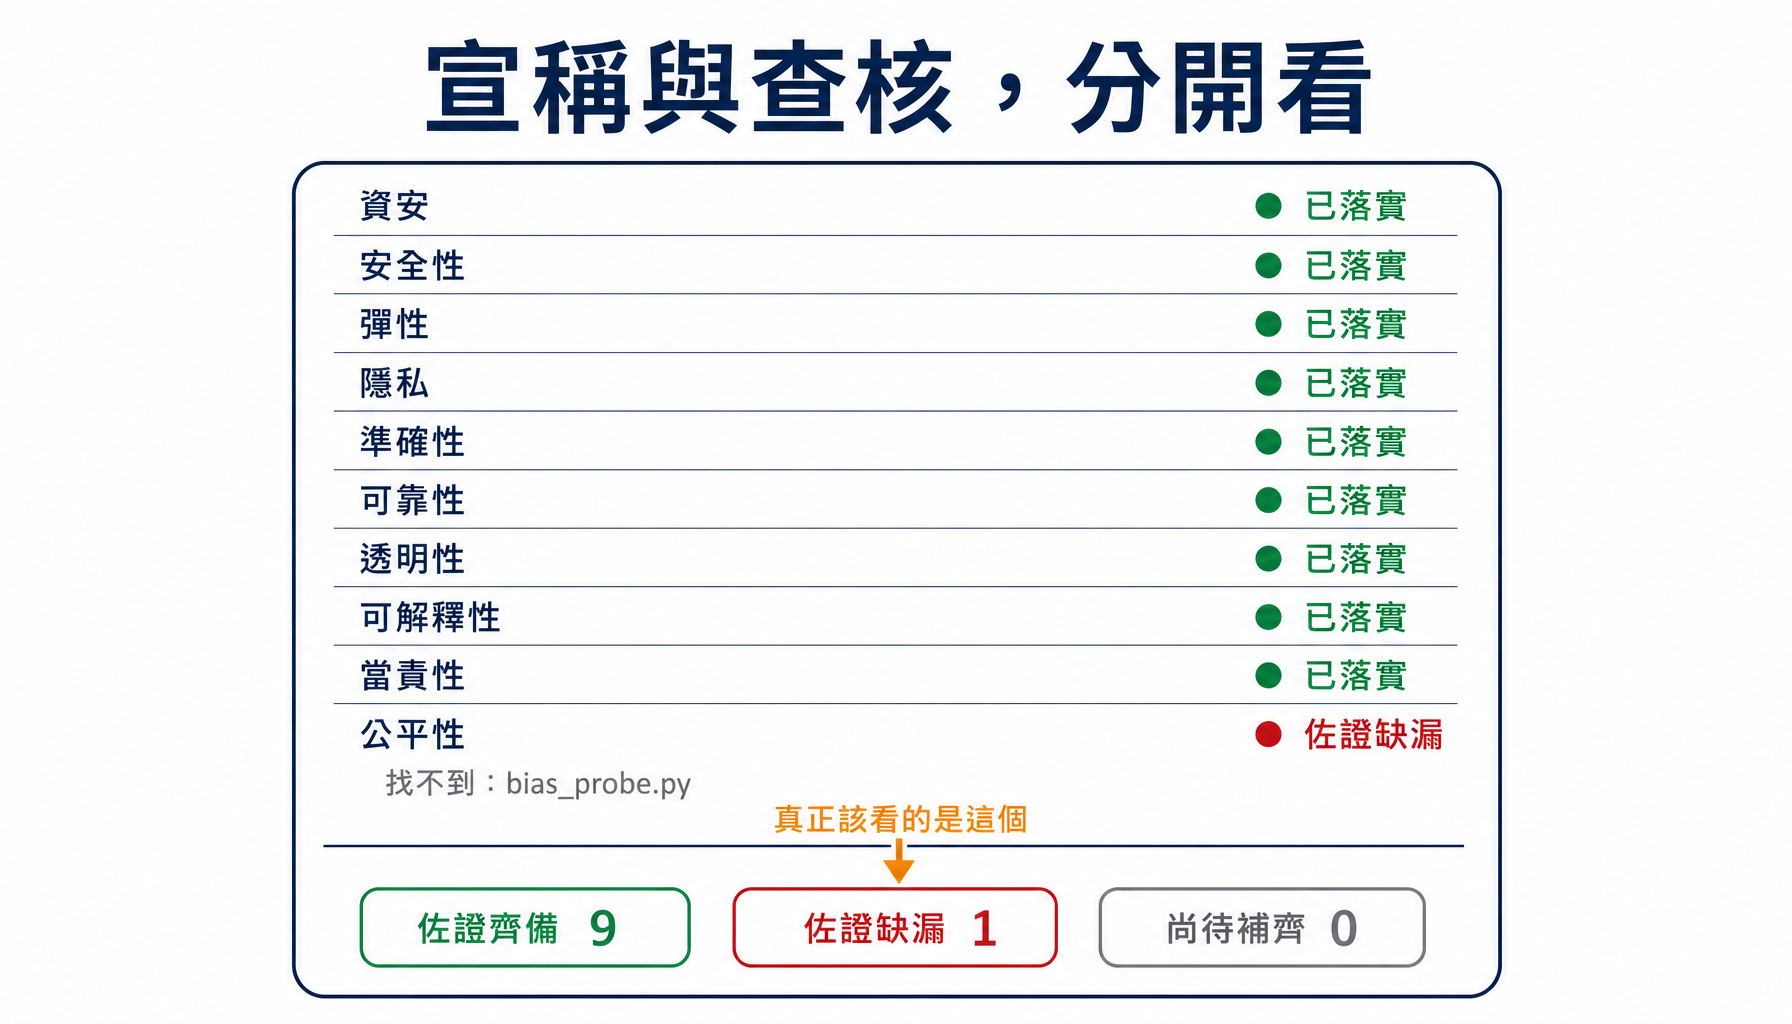
勾了,但檔案不在——當場被抓出來。 這和 Day 27 竄改稽核日誌立刻斷鏈報警是同一個道理:讓造假在機械層面就行不通,遠比在文件裡寫一句「請據實填寫」有效。
值得注意的是這一版的「尚待補齊:0 項」——如果只看這個數字,會以為十項全數完成。真正該看的是它旁邊的「佐證缺漏:1 項」。這也說明了為什麼報告要把「宣稱」與「查核結果」分開呈現:兩個數字擺在一起,才看得出有人在灌水。
跑完之後,目錄下會多出一份 自評表.md。這不是給自己看的報告,而是可以直接貼進標案文件的四欄自評表(節錄一列「符合」與一列「部分符合」):
| 要求項目 | 符合狀態 | 實作做法 | 佐證文件 |
|---|---|---|---|
| 資安:紅隊攻擊成功率歸零、越權工具呼叫全數被攔下(拒絕或改綁回本人)、AI-BOM 完整性驗證通過 | 符合 | 輸入注入防禦(D23)、存取控制與工具權限把關(D25)、供應鏈完整性(D28) | 程式碼/Day23/input_defense_rag.py、程式碼/Day25/access_control_rag.py、程式碼/Day25/tool_calling_guard.py、程式碼/Day28/ai_bom.py |
| 公平性:分群偏誤量測報告 | 部分符合 | 資料源頭治理(D22)、偏誤探測 | 程式碼/Day22/data_governance_demo.py(尚缺:程式碼/Day26/bias_probe.py) |
對照 Day 20 那一節「資安自評表:把十大評測項目變成勾選項」,會發現這正是當時承諾的東西:一份填一次、就同時回應自評表勾選、切結書承諾與 RFP 門檻的主底稿。 差別在於,它現在是程式產出的,而且每一格佐證都經過存在性查核。
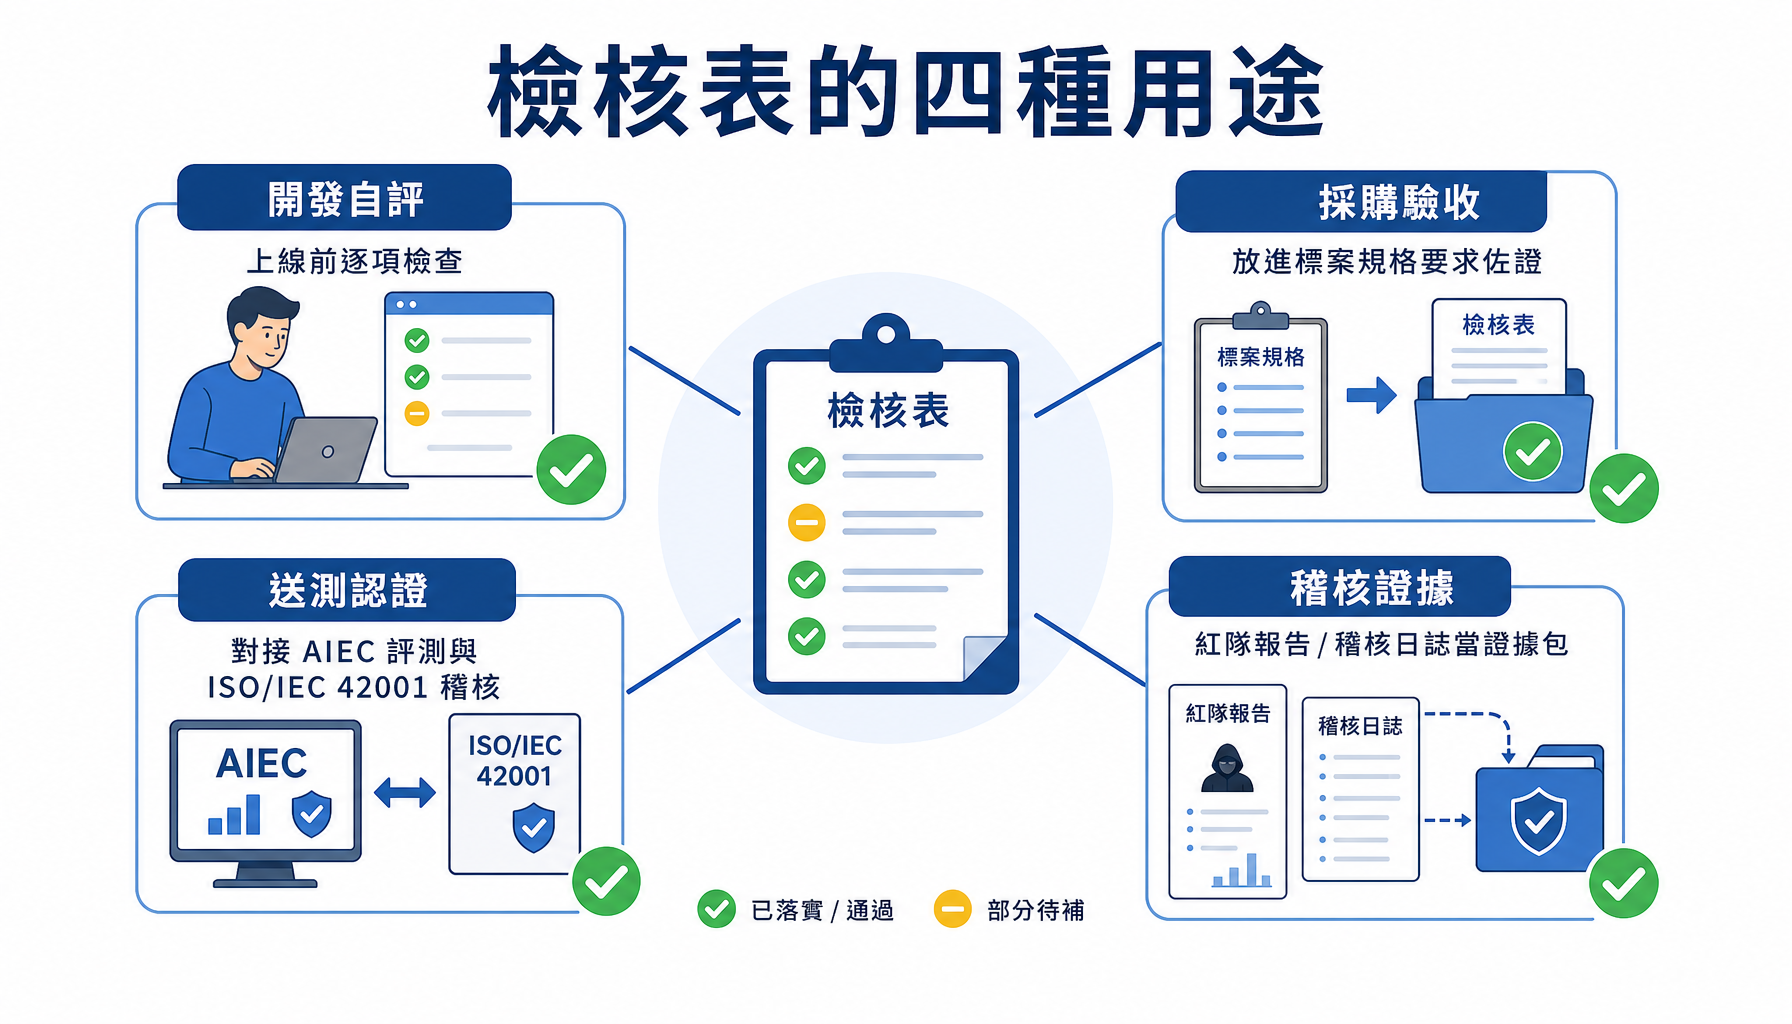
這張表和這支工具,不是寫完就束之高閣的作業,它有如下圖所示的四種實際用途:
這支工具解決了「憑空勾選」,但它的能力有明確的邊界:
bias_probe.py 放進去,這支工具一樣會放行。要往下走,得讓查核去執行測試、比對輸出、確認報告裡的數字——那是持續整合(Continuous Integration)該做的事,而這支工具只是最基礎的第一道。evidence 指向的檔案改名或搬家,查核就會誤報。這意味著這份檢核表必須和程式碼一起版本控制、一起維護——它是專案的一部分,不是附屬文件。所以正確的用法,是把它當成「持續改善的起點」:定期自評、盯著缺口、隨環境更新,而不是勾完一次就結案。
今天產出了整個系列的核心交付物——《AI 專案資安合規檢核表》,以及讓它站得住腳的查核機制:
明天(Day 30)是這趟旅程的最後一站——總結:白皮書合成與後續追蹤。 我們會把三十天的內容做一次總收束,把今天這份檢核表與自評表併進一份完整的白皮書,說明它可以怎麼再利用到真實的醫院案與政府標案,並談談這個「活的」議題該怎麼持續追蹤。從 Day 1 的一條法規縫隙,到今天這份會自我查核的檢核表,這條「從法條到程式碼」的路,明天就要走到終點。
程式碼/Day29/compliance_checklist.py(檢核表資料、佐證查核與自評表產生器)、assessment.json(誠實版自評)、assessment_optimistic.json(樂觀版,用於示範查核把關)、自評表.md(程式產出)。兩份實跑輸出均為本機真實執行結果;C10 標為部分、且 bias_probe.py 確實不存在,為對本 demo 的誠實評估,非虛構。

 iThome鐵人賽
 看影片追技術